دو عدد متفاوت برای GPT-Live: وعدهی اوپنایآی در برابر اندازهگیری مستقل
اوپنایآی مدل صوتی GPT-Live را با وعدهی پاسخ زیر ۳۰۰ میلیثانیه معرفی کرد. یک آزمایشگاه مستقل اندازه گرفت و به ۱۱۰۰ میلیثانیه رسید. هر دو عدد درستاند — و تفاوتشان مهمترین چیزی است که باید دربارهی دستیارهای صوتی بدانید.
هشتم ژوئیه، اوپنایآی خانوادهی تازهای از مدلهای صوتی را با نام GPT-Live معرفی کرد. تیترها روی یک عدد قفل شدند: پاسخ در کمتر از ۳۰۰ میلیثانیه.
یک روز بعد، آزمایشگاه رسانهی آگورا همان مدل را با دستگاه اندازه گرفت. عددی که به دست آورد ۱۱۰۰ میلیثانیه بود.
هیچکدام دروغ نمیگویند. دو چیز متفاوت را میسنجند و فهمیدن این تفاوت، تنها راه برای فهمیدن این است که آیا این فناوری واقعاً به درد کار شما میخورد یا نه؟
چه چیزی معرفی شد!؟
GPT-Live دو مدل دارد. GPT-Live-1 نسخهی توانمندتر است و پیشفرض حسابهای پولی می باشد؛ GPT-Live-1-mini روی نسخهی رایگان کار میکند. هر دو حالت صوتی چتجیپیتی را میگردانند و از راه API هم در دسترس توسعهدهندهها هستند.
نکتهی جالب معماریاش این است: وقتی درخواستی پیچیده باشد، GPT-Live خودش آن را به GPT-5.5 پاس میدهد. یعنی مدل صوتی برای روان بودن مکالمه بهینه شده، نه برای فکر کردن؛ فکر کردن را به مدل بزرگتر میسپارد.
دو عدد متفاوت، دو دلیل متفاوت
عدد ۳۰۰ میلیثانیه به زمانی اشاره دارد که سرور طول میکشد تا نخستین قطعهی صوت را تولید کند. عدد واقعی و قابل دفاعی است، ولی فقط یک تکه از زنجیره است.
آنچه شما حس میکنید چیز دیگری است: فاصلهی بین لحظهای که حرفتان تمام میشود تا لحظهای که صدای جواب را میشنوید. در این فاصله، صدا باید از میکروفون بیرون بیاید، فشرده شود، از اینترنت رد شود، پردازش شود، برگردد و پخش شود.
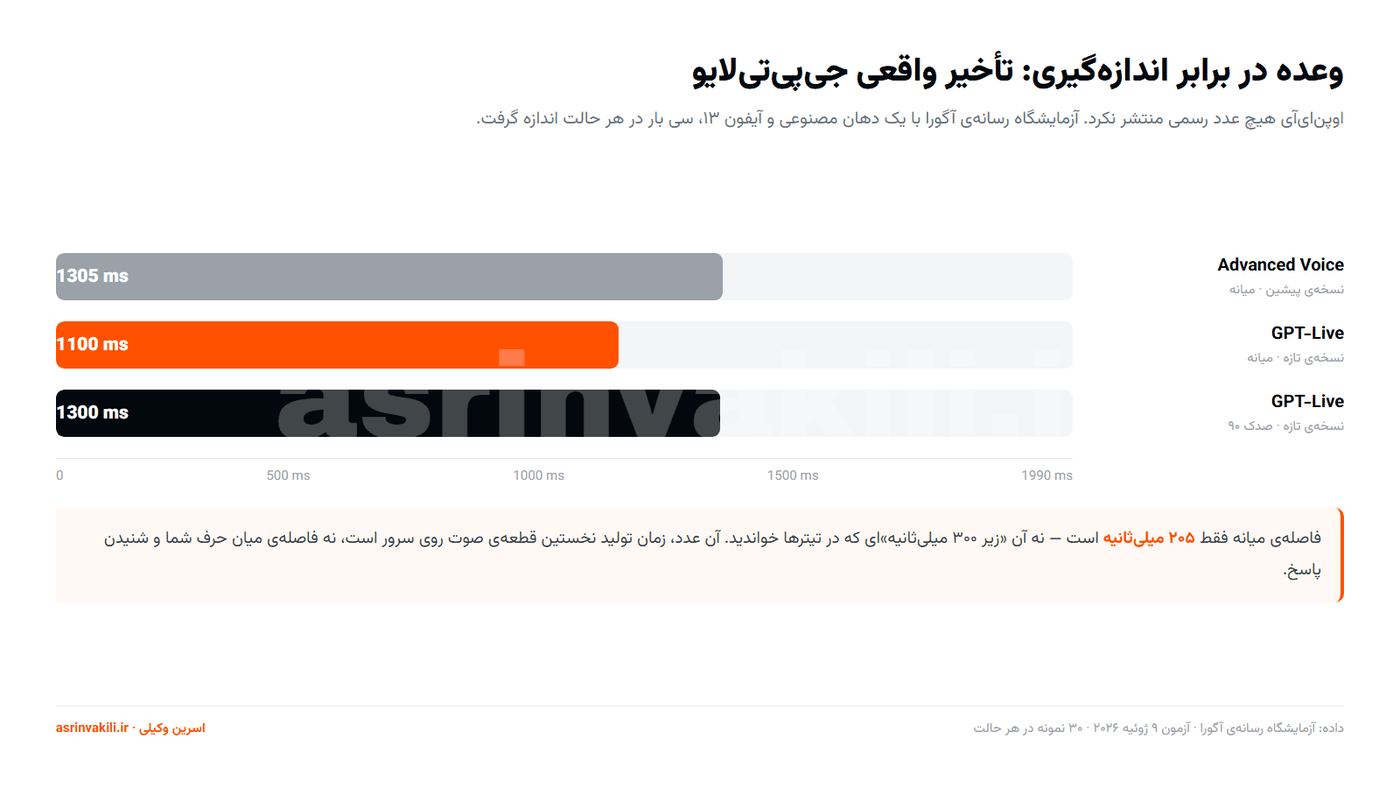
آگورا همین را سنجید. روش کارشان هم قابل بازتولید بود: یک «دهان مصنوعی» جملههای ضبطشده را برای یک آیفون ۱۳ پخش میکرد و موج صدای دو طرف همزمان ضبط میشد. سی نمونه در هر حالت بررسی شد.
نتیجه: میانهی ۱۱۰۰ میلیثانیه، و صدک ۹۰ روی ۱۳۰۰. نسخهی قبلی — همان Advanced Voice — میانهی ۱۳۰۵ میلیثانیه داشت.
یعنی بهبود واقعی، ۲۰۵ میلیثانیه بوده. محسوس است، ولی آن جهشی نیست که از تیترها برداشت میشود.
پس چه چیزی واقعاً بهتر شده؟
اینجا جای جالب ماجراست، و اتفاقاً کسی دربارهاش تیتر نزد.
انحراف معیار زمان پاسخ از ۴۸۹ میلیثانیه به ۱۰۴ رسیده است. به زبان ساده: قبلاً بعضی جوابها زود میآمدند و بعضی خیلی دیر، حالا تقریباً همیشه یک اندازه طول میکشد.
این مهمتر از سرعت خام است. مغز آدم با تأخیر ثابت کنار میآید — همانطور که با تأخیر تماس تلفنی بینشهری کنار میآید، ولی با تأخیر غیرقابلپیشبینی کنار نمیآید. همین موضوع باعث میشود دو نفر همزمان شروع کنند به حرف زدن و بعد هر دو ساکت شوند.
نسبت به شبکهی بد هم مقاومتر شده: با ۱۰ درصد از دست رفتن بسته، صدک ۹۰ آن ۱۸۳۶ میلیثانیه بود که بهتر از ۲۳۱۸ میلیثانیهی نسخهی قبلی، روی شبکهی سالم، می باشد. برای کاربر ایرانی که کیفیت اتصالش ثابت نیست، این عدد ازمضوضع سرعت پاسگویی مهمتر است.
ارتباط دوطرفه یعنی چه؟
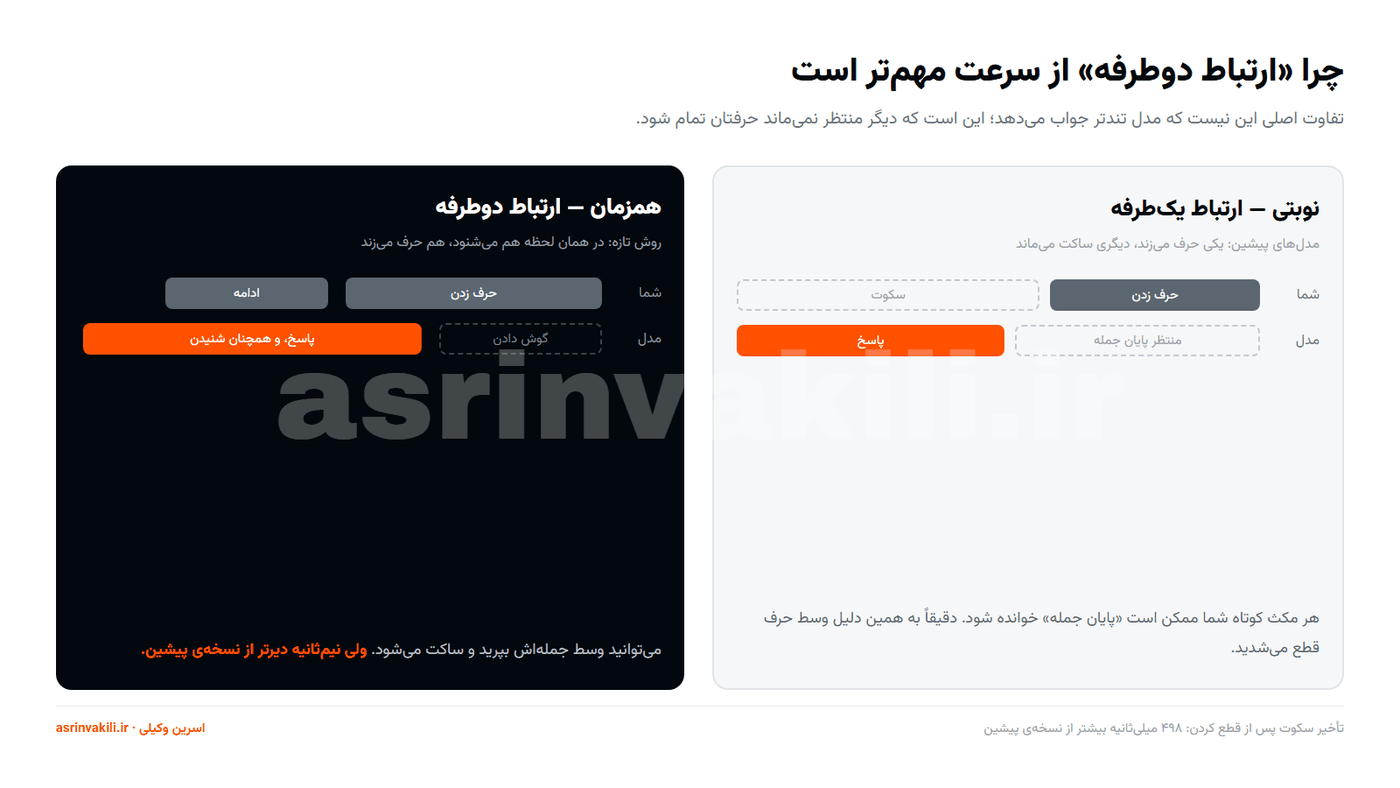
مدلهای صوتی پیشین نوبتی کار میکردند: شما حرف میزدید، سیستم تشخیص میداد که تمام شد، بعد شروع میکرد به فکر کردن. مثل بیسیم — یکی حرف میزند، دیگری گوش میدهد.
مشکلش آن لحظهی «تشخیص اتمام » بود. هر مکث کوتاه شما، هر «اِم…» وسط جمله، ممکن بود پایان نوبت خوانده شود. برای همین وسط حرف قطع میشدید.
GPT-Live همزمان میشنود و حرف میزند. مدام از خودش میپرسد آیا باید چیزی بگوید، آیا باید جستجو کند، یا باید ساکت بماند. دیگر منتظر «پایان جمله» نمیماند.
ولی یک عقبگرد هم دارد که در اطلاعیهها نیست: وقتی وسط حرفش میپرید، ۴۹۸ میلیثانیه دیرتر از نسخهی قبل ساکت میشود. نیمثانیه حرف زدن روی حرف کسی، دقیقاً همان چیزی است که آدم حس میکند.
برای کار در ایران چه معنایی دارد؟
سه نکته که در هیچ اطلاعیهای نیست:
مسافت، به عددها اضافه میشود. ۱۱۰۰ میلیثانیه در آزمایشی به دست آمده است که فاصلهی شبکهاش کوتاه بوده. هر میلیثانیهای که بستهی صوتی شما تا نزدیکترین سرور طی میکند، دو بار به این عدد اضافه میشود.
کیفیت فارسی هنوز نامعلوم است. همهی این اندازهگیریها با گفتار انگلیسی انجام شده است. مدلهای صوتی معمولاً روی زبانهای کمدادهتر هم کندتر و هم کمدقتترند. تا کسی با فارسی نسنجد، این اعداد را نمیشود به فارسی تعمیم داد.
پیش از ساختن، بسنجید. اگر میخواهید روی این API چیزی بسازید — پشتیبانی صوتی، منشی تلفنی، دستیار داخل اپ — اول با کاربر واقعی و شبکهی واقعی تست کنید. ابزارهایی مثل n8n این اتصال را بدون کدنویسی ممکن میکنند. عدد اطلاعیه، عددِ محیط شما نیست.
چه چیزی در راه است
همین هفته گزارش شده که اوپنایآی آزمایشهای داخلی مدل تازهای با نام رمز GPT Astra را گسترش داده. چیز دقیقی دربارهاش منتشر نشده و هر تحلیلی الان حدس است، ولی الگوی همیشگی این شرکت نشان میدهد که گسترش تست داخلی معمولاً چند هفته پیش از انتشار عمومی اتفاق میافتد.
حرف آخر
دفعهی بعد که عددی دربارهی سرعت یک مدل خواندید، یک سؤال بپرسید: این عدد از کجا تا کجا را میسنجد؟
فاصلهی بین «۳۰۰ میلیثانیه» و «۱۱۰۰ میلیثانیه» نشانه دهنده دروغ نیست؛ بلکه تعریف متفاوت از یک کلمه است. و تقریباً همیشه، آن تعریفی که به تجربهی کاربر نزدیکتر است، عدد بزرگتری میدهد.
بیشتر بخوانید
اگر میخواهید ببینید همین مدلها را چطور میشود بدون کدنویسی به کار گرفت، معرفی n8n نقطهی شروع خوبی است.